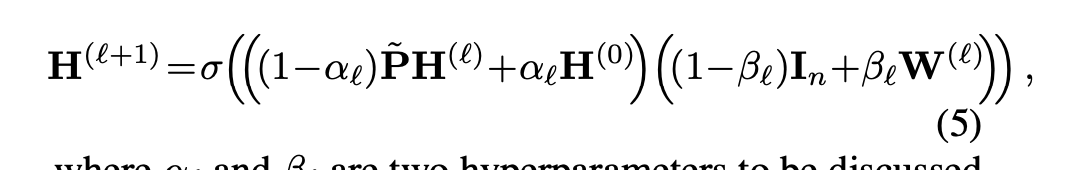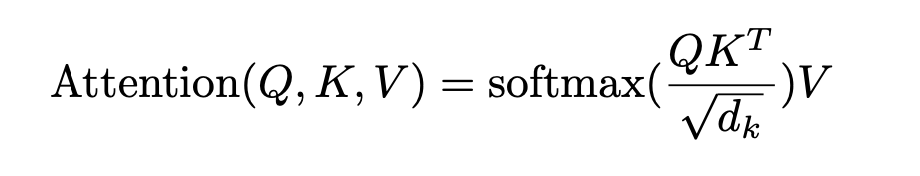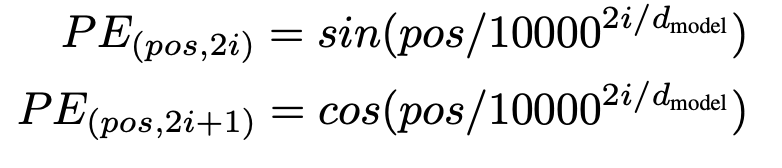0%

前言。本文作于GCN横空出世(2017)的三年后(2020),想尽可能在简单易懂的情况下说清楚近年GNN的发展脉络。当然,凭我鸽子王的尿性,估计本来也就不会写的很翔实(简单是第一层,偷懒是第二层🐶)。

4th, March, 2021. Update: After a series of rejections by AI conferences, I note that I may look back on these papers and rethink why these papers can be accepted, i.e., review them in a positive and admired way instead of criticising them. Also, I try to pay attentions to the authors and institutes, and summarize the research style of different groups. This helps to understand the whole GNN community and “may” contribute to my PhD dicision.

最近GNN又看了一些ICLR2020的paper,加之之前积累的paper,对整个GNN的发展脉络有了比较清楚的理解,之所以想要记录在案,是因为发现:

  • GNN有点类似CNN,是一个入门难度不高,效果又比较出色的技术。不像EDA里面各种子问题及现在的SOTA解决方案,要解释清楚就要半天。
  • 现在的各种文章因为作者们的严谨及数学功底的雄厚,导致涉及内容过多,我要真正看明白的阈值太高(对不起实在是因为我太菜了),因此心里琢磨着要是能有一篇浅显易懂的综述,快捷的理清paper间的区别和发展脉络该多好。
  • 现在许多GNN的paper其实真正technique部分的contribution很容易概括,当然所谓的research也不可能是一蹴而就 novelty、results什么的全都完爆previous work。只是很多paper的出发点都不一样,导致看起来paper间差异很大,其实在我看来现在GNN还是一个比较混沌的状态,等着哪位X kaiming大神来盘古开天。(或者说GCN这篇就算是开天了?)

Note:这篇文章完全是为我本人量身打造,是为了未来的我复习GNN的时候有个参考。因此我面向的读者是有了比较充足的CNN、Graph知识背景的。

开山老祖 GCN

这一段大部分是我的臆测。。可以直接看结论。

给一个irregular的grpah/point cloud,我们可以从频域(specture)和空间(spatial)角度去解决这个问题

  • 频域角度就是图信号映射到频域后再做卷积操作。(直接copy from zhihu,原谅我这一块其实并不是很清楚,因为现在的大部分work都不会提specture这个东西了。。。而且本身这个对数学功底要求就有点高,也许我真的phd了可以花时间研究这个?单就目前纯水paper的角度,这个建议不要碰,1.上手难,2.现在大部分SOTA都是spatial)
  • 空间角度大概就是直接从点/线的关系入手,用这些关系来表示某种message passing。messgae passing的意思很简单,就是说给一个点,它会把它自己的信息(feature)传输给它的邻点,同样,它的邻点也会把邻点的信息传给它。大概有点像社会学里面的信息传输,譬如李巍长得很帅,一传十十传百所有人都知道我长得很帅这样。。(我长得很帅这个信息就被所有人收到了,这样在他们那的信息就是:我有个朋友/朋友的朋友长的很帅)

这篇GCN做的就是,从频域角度出发给了GCN的公式:

[公式]

$H^l$就是第l层的所有点的feature,$\bar{A}$是加上identity matrix的矩阵,D是degree matrix为了normalization(结果其实比较接近mean),W就是映射到另一个空间增加信息量。

然后发现这个公式其实可以从空间的角度很elegant的解释,GCN的每一层其实就是aggragation + combing(encoding)

  • $\bar{A}H$ 其实就是对于任何一个点,将自己的feature,以及邻点的feature 累加起来,加个D就是为了normalization($D^{-1}$ 其实就是mean),因为每次都累加层数多了这个值不爆炸了?而且有些点邻居本来就多怎么办?。
  • $W^{l}$ 就是做一次combing啦,可以理解成投射到另一个空间增加复杂度(其实就是1*1conv,or FC,or MLP,哦,有的可能还会加个bias)

方法层面

GraphSAGE

这篇就直接不管specture了,直接从空间角度把GCN重新提了一遍,同时formally定义了aggregator这个概念,其实就是对于每个点,怎么将它自己及它邻点的信息聚合(aggregate)起来。然后还提出了几个方法。

  • 不加自己的feature mean 。
  • 加上自己的feature mean。。。
  • LSTM。。。也许那个年代LSTM比较火吧。
  • channel-wise的max sampling

注:aggregator其实总之不管是什么,都只要保证order-invarienty以及size-insensitivity就行了

GAT

这篇就是说attention效果这么好,我们也套用到GCN吧!(对不起这是我的小人之心🐶),实际上应该是:每个邻居可能重要性不一样,所以要加个attention!

[公式]

a(i,j)就是点i对点j的重要性。但这个真把我秀到了,具体可以参见https://wadmes.github.io/2019/12/30/attention/

JKNet

这篇就是说DenseNet效果这么好,我们也套用到GCN吧!(其实background还是GCN层数过深,例如depth>2,就会出现oversmooth的情况,即所有离得近点的feature长的都挺像的。而离得远的点互相的connection又太小了,所以加个densenet就可以让他们connection不小了呀呀呀呀呀呀)

提到oversmoothing了就说下,其实直接原因是目前GCN的aggregation必须保证order invarienty,导致不像CNN里面的convolution kernel一样卷积时候可以带weight,想象一下CNN里面a pixel的右边是b pixel,传信息的时候用的是3*3kernel里面的(2,3)value,而b要传给a,就是(2,1)了,两个值不一样,所以不管传多少次都不会最后比较接近,除非(2,3) = (1,3),这就是GCN现在的情况,因为GCN不可能还有方向这个概念,或者说,给一个点a,他有邻居b,c,目前还不可能能分出b,c。。

DeepGCN

这篇就是说ResNet效果这么好,我们也套用到GCN吧!

然后除了简单的加个residual connection,还提出了一个GCN上的dialated convolution,个人觉得是比residual 更重要/有效的一点。大概就是:regular CNN里面dialated convolution可以很轻松的跳一个选一个这样卷积,但是GCN不好操作因为每个点邻居个数都不一样,而且还是无序的。这里的做法就是对于每个当前点,给其他点按照feature的欧几里得距离来个排序,然后就可以跳一个选一个啦!(其实有点做point cloud里面dynamic graph CNN那味了)

Dropedge

这篇就是说Dropout效果这么好,我们也套用到GCN吧!

不过这里的dropout其实不同于CNN里面对feature的dropout(其实对feature的dropout在original GCN就用了),而是对weight的dropout,即每一层有概率的remove edge,(脑补一下,其实就相当于把GCN的weight全为1 改成了有些为0有些为1啊!)

Position-aware Graph Neural Networks

这个不是借用CNN的一些technique的理念,说下大概思路吧。

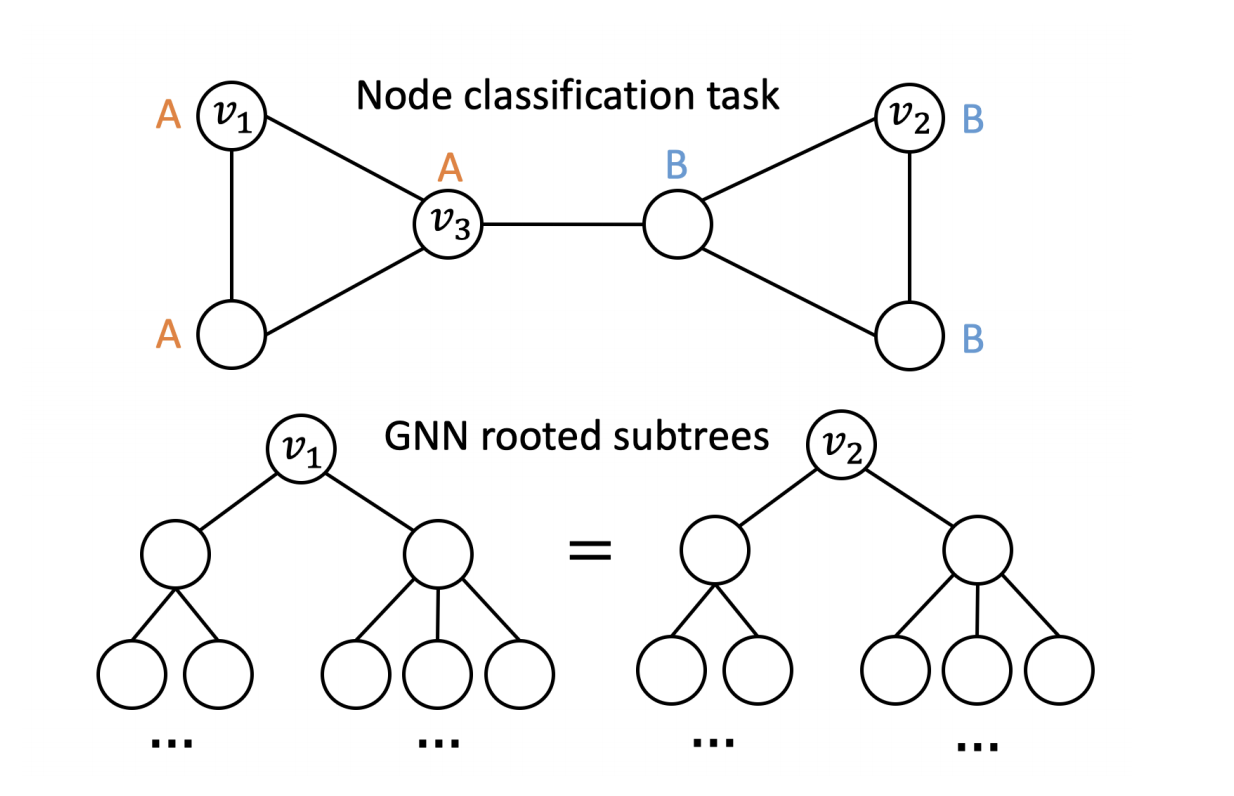
  • 问题:GCN只能捕捉局部的structure 信息,比如:

    image-20200627214400158

    不管怎样$v_1,v_2$(structurally isomorphic nodes)都是分配同样的label。那么怎么解决这个问题呢?

    node position can be captured by a low-distortion embedding by quantifying the distance between a given node and a set of anchor nodes

  • 先说下workflow吧,

    • 给$clog^2n$个子集$S_{i,j},i=1…\log n,j=1,…,c\log n$,每个子集会随机选择所有点,每个点被选中的概率为$1/2^i$,所以其实子集的大小其实是指数型增长的
    • PGNN的每一层operation如下,
      • 对于每个点,和每个子集里面的所有点(假设n个点)的featrue(假设d维) concat 起来->$n\times 2d$,如果子集里的点是距离为$k$外的(太远了),则return zero值(而不是concat feature)。接着把concat结果aggreate起来-> $2d$ (注意这里的aggregate也需要满足order invarianty!所以也只能用mean,max,sum等,作者直接用的mean)
      • 对于不同的子集的结果再用aggregate $c\log^2n \times 2d \rightarrow 2d$。
  • 总结:这篇的theorem用了Bourgain Theorem去证明只要$c\log ^2 n$个就子集就可以preserve the distances in the original graph with low distortion。。。不过很多paper里面的theorem都是比较巧妙的,让人觉着遥不可及。但是这个work解决GCN只有local structrue的大概方法也是类似的:就是想方设法的介绍一些global information进去,这里是通过介绍子集的方法,相当于给子集中的每个点多了一个额外信息:属于哪个子集。打个比方,假设所有人只有性别这一个label,我和坤坤都只有三个男性朋友,一个女性朋友,这样一层GCN就无法通过信息传输判断我的label了,但是如果创造2个子集(身份),分别是 爱rap的同学 和 爱打篮球的同学,然后发现我有一个爱rap的同学,2个爱打篮球的同学,坤坤有3个爱rap的同学,这样我和坤坤的label就是不一样的了。

COLORING GRAPH NEURAL NETWORKS FOR NODE DISAMBIGUATION

引入了universal representations & separability的概念,claim MPNN不是一个universal representation。解决方法(甚至出发点)和上篇paper有点相似。大概就是给node attribute 相同的点 从k种颜色中随机选一个颜色标上,k为hyper parameter,这样就实现了universal approximation。有两个concern

  • 若k不为 graph size (即所有点颜色都不一样),那么这种coloring sheme不是permutation invariance。这也是ICLR被拒的原因。
  • k=1时,不就是所有点assign一个相同的颜色么。。没看懂。。。

GeomGCN

同样,这个也不是借用CNN,说下大概思路吧。

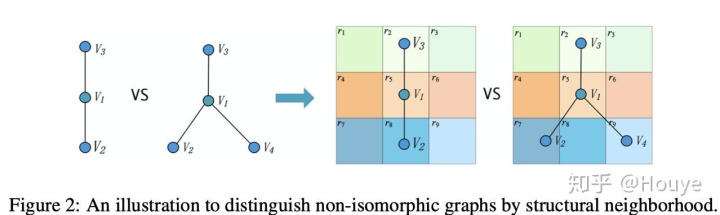
  • 问题:1. 就像GIN说的(就这篇下面👇),现在基于聚合的都是垃圾,因为会将部分Non-isomorphic的图也给出同样的结果,如
    img

    1. 同样的 有些graph里面可能有些子图其实是有相似结构的,那么为什么不利用起来呢?
  • 基于以上两点,可以大概构思怎么解决 1. 将不同的node 当作不同的neighbor来聚合 2. 给每个node 加上一个能表示局部结构的node (这样局部结构相同的两点其实就可以share同样的feature了)

  • 所以大概workflow如下:

    • 给每个点计算latent space上的node embedding,注意此处的node embedding是仅仅包含local struture 信息的(原文用了一些GCN之前的获取node embedding的方法,真的很纳闷为什么不直接用SOTA的GCN来获取node embedding)
    • 对于每个点centroid,它都有两种邻居:真实邻居,转化成latent space下的邻居(另一个时空下的恋爱🐶),然后将每个邻居按照与centroid在latent space中的位置关系分为不同的邻居(为了解决第一个问题)。这里的实验latent space是二维的,所以邻居只分了四种,左上右上左下右下。
    • 这样对于每种邻居,我们就分了四种点,这样就有四个aggregator,最后四个aggregator结果concat起来就行(因为总得保证是固定个结果嘛)

Generalization and Representational Limits of Graph Neural Networks

定义decide:一个GNN Q如果decide了一个图性质P,则说明图性质P不同的两个图,由Q产生出来的graph embedding也肯定不同。

这篇文章前半部分就是用一些例子证明了:

  • (用一些反例)基于聚合的很多GNN不能decide很多很简单的性质。

Simple and Deep Graph Convolutional Networks

Use two simple techniques to make GNN deep

  • Partially aggregate the input feature $H^0$, instead only aggregating previous layers features from its neighborhood

  • Adding a partial skip connection part

  • image-20210311110145347

PAIRNORM: TACKLING OVERSMOOTHING IN GNNS

Another paper to handle with oversoothing issue in GNNs, i.e., cannot generalize to deep network.
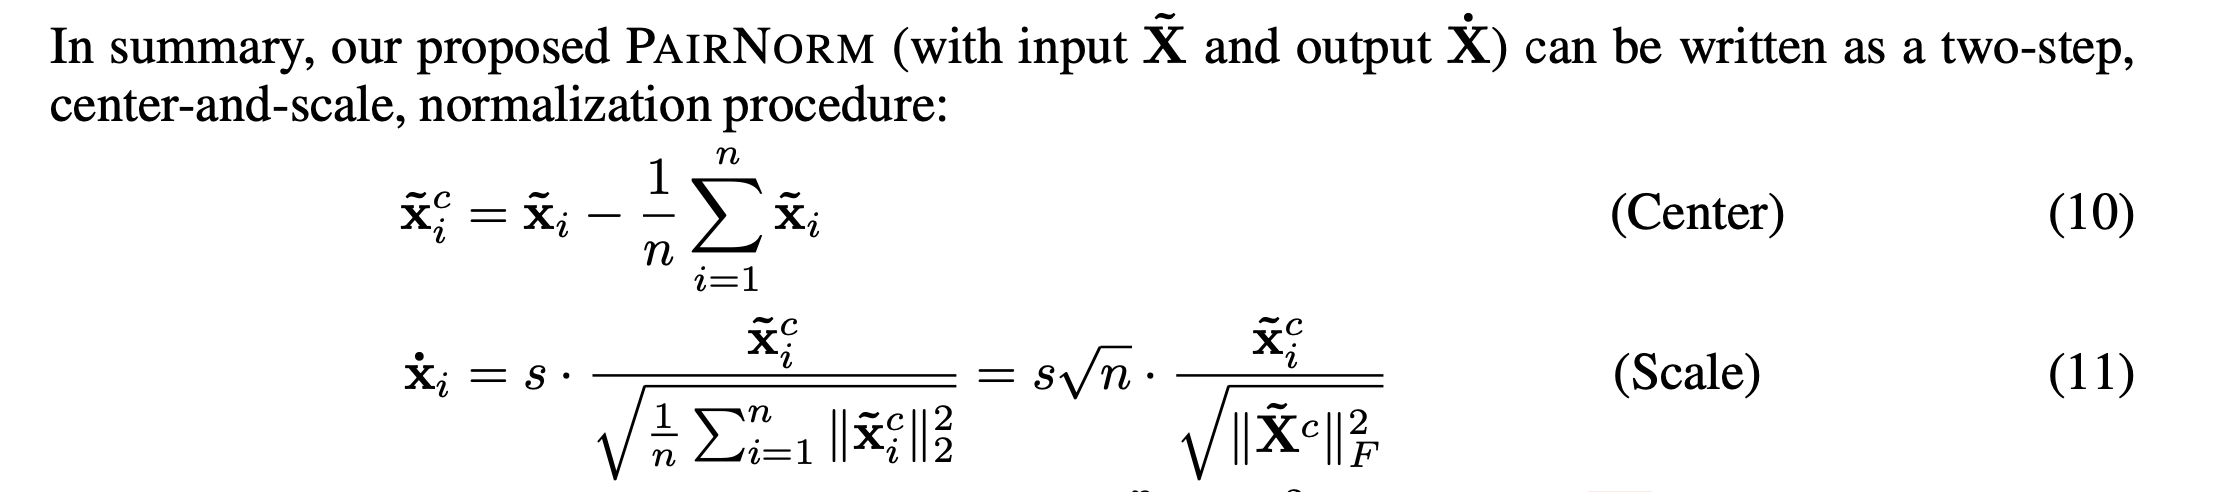
image-20210311114447474

Here, n is the number of nodes.

The normalization is simply used for the output of each layer

Simplifying Graph Convolutional Networks

Non-linear 在很多任务中没什么用,GNN可以直接用一个很简单的linear model来表示:

$Y = softmax(S^KXW)$, where $S = normalized \ A$

理论层面

GIN

这个算是个人觉得最有意思的一篇了,大概就是说在座各位基于这种聚合的都是垃圾,最多也只能和从前的WL Test一样。https://wadmes.github.io/2019/09/14/GNN-GIN-GMN-study/

Weisfeiler and Leman Go Neural: Higher-order Graph Neural Networks

A very good paper that proves a similar conclusion with GIN. (the difference is that they use linear transformation instead of MLP, and finally claim that double the layers (which becomes MLP actually) can have the same performance with WL test)

And then propose a k-GNN based on k-dimensional WL test. Basically, the “supernodes” is all k tuples of the graph.

THE LOGICAL EXPRESSIVENESS OF GRAPH NEURAL NETWORKS

这篇(ICLR2020)大概就是接着上一篇GIN(ICLR2019)说,诶,确实以前的聚合(自己的+邻居的)都是垃圾,但我这个不一样了,对于每个点还有了个全局(readout)信息。

首先先从一个最简单的给点二分类的问题说起:如果要判断一个点是不是isolated node。我们是不是就没法正确分类了?因为true的点肯定没法传输信息。这个例子实在是妙啊。。

那么这个全局信息是什么呢?就是所有node feature的sum啦。。(ps。。头皮发麻)

WHAT GRAPH NEURAL NETWORKS CANNOT LEARN: DEPTH VS WIDTH

这篇文章的作者。。emm。。怎么说呢,一看就不是国人同时又是为计算机基础知识特别好的大神。

文章的证明需要比较强的计算机背景,不过结论很简洁易懂:

该研究证明,如果我们想让 GNN 为常见的图问题(如环检测、直径估计、顶点覆盖等)提供解决方案,则节点嵌入的维度(即网络宽度 w)与层数(即网络深度 d)的乘积应与图大小 n 成正比,即 dw = O(n)。

Approximation Ratios of Graph Neural Networks for Combinatorial Problems

这篇将GNN和distributed local algorithms 结合了起来,先证明了GNN和distributed local algorithms 是等价的,然后利用以前work对distributed local algorithms的研究得出的结论直接给出了GNN的一些结论。

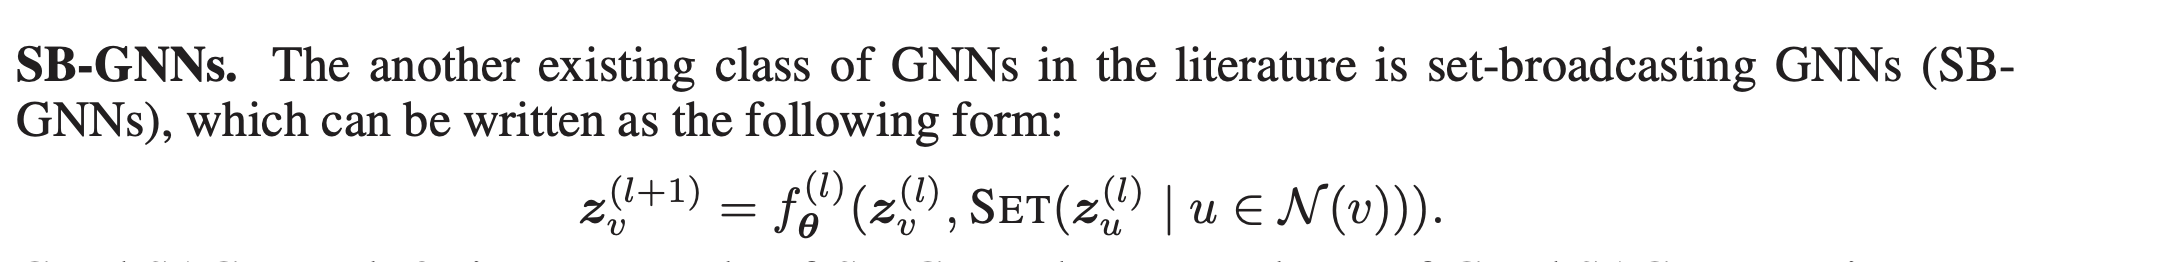
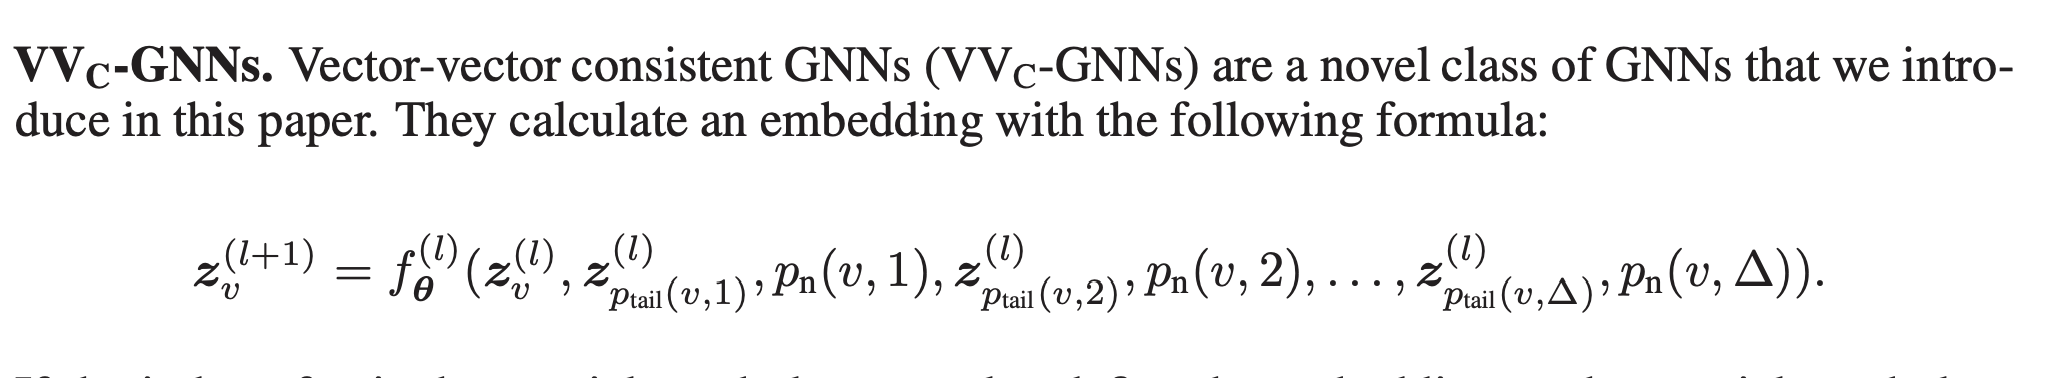
大概就是现在两种GNN, MB-GNN 和 SB-GNN都比不上 VVC-GNN,定义分别是:
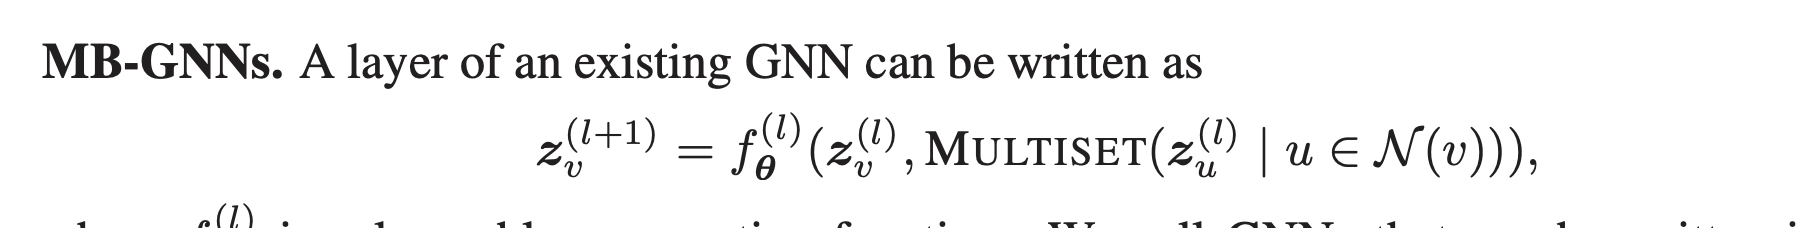
image-20200819215408321

image-20200819215427294

因此,提出了一个VVC-GNN。大概意思就是给别一个边的两个出口都assign一个port,使得所有点给它邻点的信息完全不一样。

最后实验就是用这个model + reinforcement learning 证明了 这个model可以解决很简单的组合优化问题,但是MB,SB都不可以。

在我看来,有个点是没解决的:

  • 这种方法注定导致不能迁移到其他graph(相当于给每个edge的port一个人为的index)
  • 这个方法训练时间需要很久,但同时不能用到其他graph。。也太扯了吧。

关于distributed local algorithms的定义,请参考 https://arxiv.org/pdf/1205.2051.pdf

Distance Encoding – Design Provably More Powerful Graph Neural Networks for Structural Representation Learning

添加了一个distance encoding to encode certain distance from S to a node u, 其中S是图中的一部分structure,想学的target structure feature就是S的feature,若S为全图,则为全图的feature(graph embedding).

这里的distance encoding 有比较复杂的formal形式,但是实验里面用的其实就是最简单的两点之间最短距离。

Design Space for Graph Neural Networks

Motivation:

  • Surging new GNN tasks, with different requirements
  • Large design space of GNNs

Design space:

  • BN; Number of Pre-process layer (MLP); Number of Message Passing Layers; Sum/Mean/ and son on

Task space:

  • Synthetic tasks: node features/ labels/ node/graph classification
  • Real-world tasks: 6 node classification benchmarks from [26, 28], and 6 graph classification tasks from [14].

GraphGym

  • Modularized GNN implementation
  • Standardized GNN evaluation.
  • Reproducible and scalable experiment management

Results:

  • BN good!
  • No Dropout good!
  • PRELU good!
  • SUM good!
  • Adam good (compared to sgd)
  • 400 epoch good than 100,200

However, besides these “common-sense” conclusions, desirable design choices for Aggregation, Message passing layers, layer connectivity and post-processing layers drastically vary across tasks

Tasks can be roughly clustered into two groups:

  • (1) node classification over real-world graphs; with rich node features; GNN designs that can better propagate feature information are preferred;
  • (2) node classification over synthetic graphs and all graph classification tasks; require graph structural information

How to determine the “best” design for a new task?

  • using $M=12$ echor models to test the task,
  • find the most similar task based on the rankings of the echor models.
  • use the best design of the most similar task as the “best” design

Identity-aware Graph Neural Networks

Background

  • MP GNN cannot distinguish nodes with the same computational graph.
  • Although task-specific feature augmentation; is not generic and hamper the inductive power
  • Previous works task specific; and not based on MP GNN->not efficient
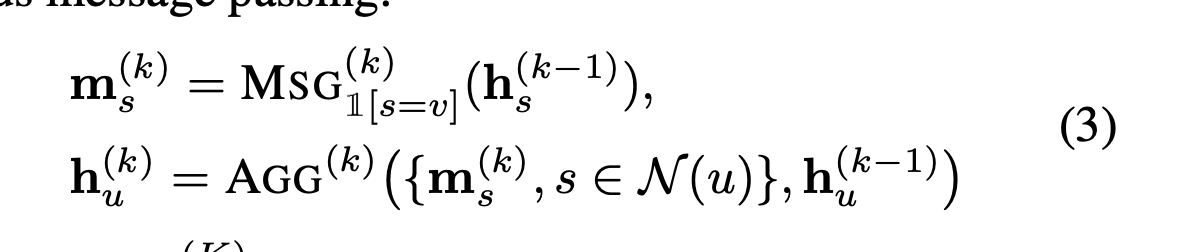
image-20210306233434885

DropGNN: Random Dropouts Increase the Expressiveness of Graph Neural Networks

非常漂亮的文章!

大概就是GNN的upper bound是WL,那么有没有可能突破这个upper bound呢?方法是简单的randomly drop node,这样一个graph 就对应成了 一堆graph 的distribution,那么不同graph 的distribution大概率是不一样的!

这个问题是相同graph的distribution也可能不一样,除非randomly drop的次数足够多,就像投硬币一样。文章里面还给了solid proof about the probability of the distribution close to the real likelihood.

将statistics 里面的一些东西运用到graph里面来,感觉很有潜力啊!

Some other interesting papers

NEURAL SUBGRAPH MATCHING

Done by Stanford Group. The problem is to determine the presence of a given query graph in a large target graph.The key insight that makes NeuroMatch work is to define an embedding space where subgraph relations are preserved. That is, : If $G_v$ (k-hop neighborhood of node v) is a subgraph of $G_u$, then node v should be embedded to the lower-left of u. Such relationship is preserved in the embedding space by an elegantly-designed loss function:
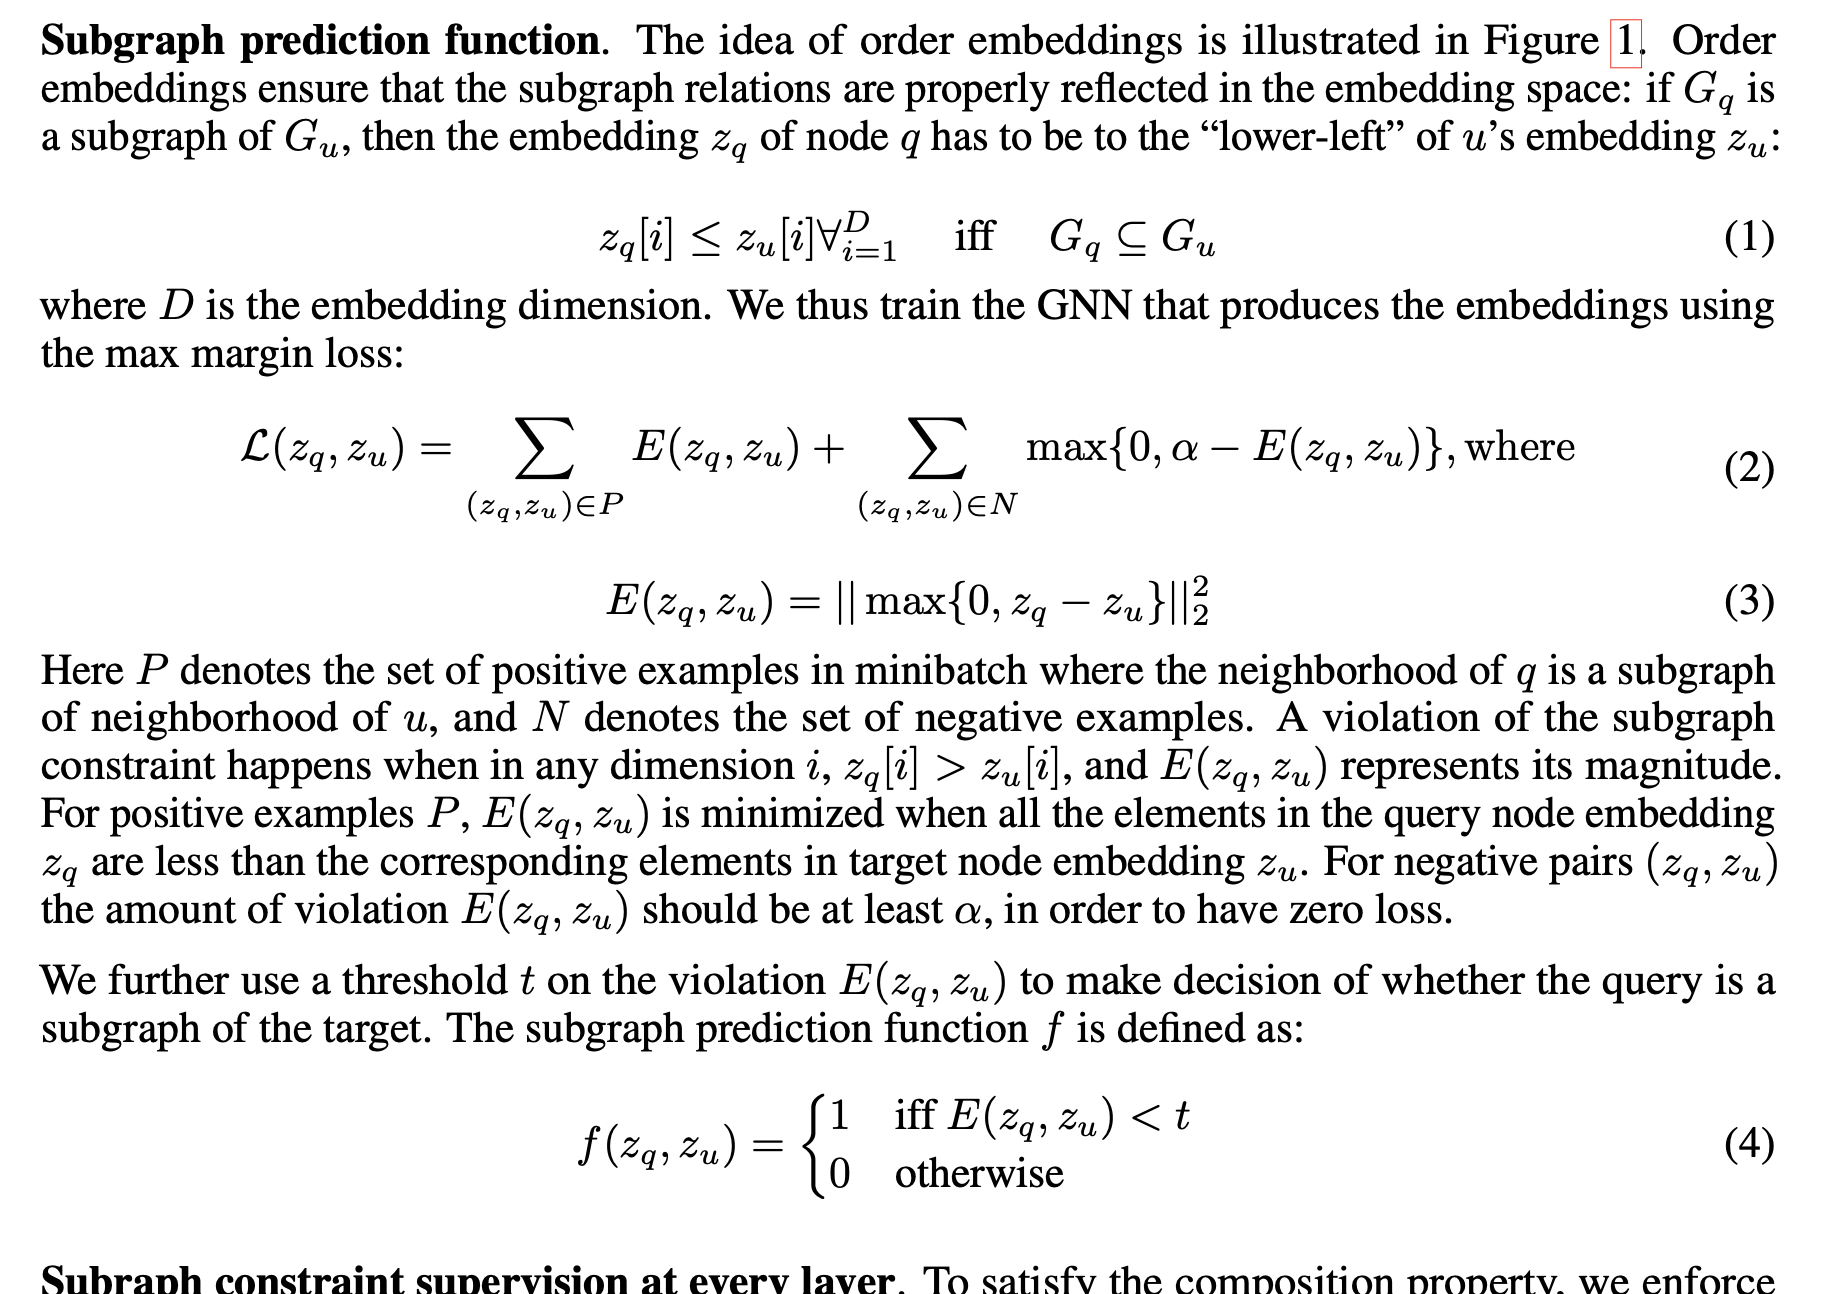
image-20210306233700395

Beyond Homophily in Graph Neural Networks: Current Limitations and Effective Designs

This paper discusses GNNs in graphs where connected nodes may have different class labels and dissimilar features.

Three techniques are used:

  1. concatenate aggreated features insteaed of sum or mean them
  2. Higher-order Neighborhoods, concatenate two-order neighborhood
  3. concatenate (at the final layer) all learned ego-representations at previous layers

后记

写完后,忽然发现了一个也可以算巧合的规律吧?所有方法层面的work基本都是国人lead,但是理论层面的work却寥寥无几。这算不算是一种悲哀呢?方法层面的东西固然重要、效果好,容易发paper,但是理论层面的才是有可能真正推动时代进步的那个钥匙,不过似乎大家都对这种“不好发paper”、“没有确定性”、“难入门”的东西有一种共识性的排斥,算是一种悲哀吧!

其实自己何尝不是这样呢。做了五六个work,除了openmpl,其他的基本都是比较讨巧,迎着市场需求(学术圈热点)做的东西。这是这个时代的无奈,也是我个人的无奈吧,其实也是蛮想做一个沉下心学习研究一两年然后真正contribute to the development of CS的东西,可是现在还只是一个再过几个月要靠publication去砸PHD commitee脸的小小mphil;就算phd了也只是一个担心qualification、担心graduation的PHD student/candidate;就算当教授了也需要paper去争tenure啊;就算当了professor,也得对学生负责,在他没有成果前不可能让他做一些我自己都无法保证的东西吧?好像真正可以肆无忌惮做这种work的时间段只有achievement差不多时候的PHD year4/5了?

扯的有点多,说回GCN吧。总的看来,其实各种technique/theory还是在发展中的,不过里面确实还有很多可以发掘的东西,而且从功利化发paper的角度,不仅仅是Common GCN, 很多子分支,譬如point cloud,譬如heteogeneous graph(参考[https://wadmes.github.io/2019/12/17/heterogenous%20network/](https://wadmes.github.io/2019/12/17/heterogenous network/)) 这些子分支都是水paper的好方向哪。。

另外就是虽然所有paper的conclusion或者method看起来很简单:这不是本科生都能想到的吗?但是里面的story writing绝对是我得好好研究的:怎么将一个简单的solution包装的很elegant,它解决什么问题的?有什么理论去支撑的?实验怎么设置?这里面都是学问啦。总之,虽然novelty不够,但是发现了这些work的一些共同点:

  • 大部分都有看起来牛逼哄哄的theorem/proof(对不起因为大部分theorem我没有仔细看,所以只能暂时说看起来。。。)
  • results部分不会特别出彩,但肯定不是完全比不上别人。1% improvement 🐶,当然如果是专为解决特定问题的,譬如logical问题的那位,就是可以完爆了。
When we finish a paper draft by latex, we may find it difficult to directly use Grammarly to check the grammar since our paper is a .pdf format.

Here is a simple instruction to use Grammarly for your paper. If you have some other more elegant methods, feel free to leave a comment here. :)

Here are the steps:

  • Copy the text in the paper and paste it into VSCode

  • Replace all “\n” terms into space “ “ terms

  • Copy the processed text in VSCode and paste it into Grammarly

  • Find the error and fix it.

    ![截屏2020-06-17 下午7.19.53](/figures/截屏2020-06-17 下午7.19.53.png)

离ICCAD还有三星期的时候和老板说想放弃投ICCAD,最后在他的“威逼利诱”下,再加之自己的年轻气盛还是答应了并全力以赴的完成了。想想也是蛮了不起的,不过最后一两个星期实在是太累了点,希望以后还是少点这么肝的时候吧。

这大概一个月,一边做proj一边就有新的感触,每有一个感触,都会自己先记一笔,然后不知不觉的备忘录上就塞满了感触。。。现在一次性都记下来当作以后的吸取教训吧。

Idea & Paper Review

前面两个proj 都分成了c++ 和python/pytorch两个板块,因为比较尊重本科生的意见,所以都让他们先选负责的板块(所以都是选的python)。但是有个严重问题:pytorch部分往往和整个proj的idea相关,所以让本科生看paper 找idea实在是好刚没用在刀刃上。因此 两个proj都耽误了比较长的时间。好在自己看paper 总结idea的水平还是比较高了,后面都很快的调整好了方向。

以后在我看来本科生的帮助应该是:

  • 跑实验这种大家都需要时间成本,而且学习成本较低的work
  • 画图,implementation就取决于本科生的学习能力和是否有过类似经验了。倘若我和ta都没学过,那让ta来学一下画图也可以(学习成本一个人花费就可以了)
  • 整个idea方向,除非是比较厉害的本科生(这么看我当年其实还是蛮厉害的,在南科大work都是我来看paper想idea),否则应该是我来看paper 总结,想idea,同时简单的传达意思给ta。毕竟确实我看paper的经验,水平肯定高过大部分本科生的。

最后再吐槽下吧,好羡慕南科大有那么多本科生帮忙,然后本科生也有各种1/2/3作paper,实在是双赢。CU的本科教育就花在了倾庄、人文教育上了(当然有research,但是比起内地学校有组织的research还是差远了)。

Coding style

这是看了DGCNN的mit学长的code发出的感慨。感觉任何语言,尤其python,必须要有一套自己习惯的coding style,包括但不限于:

  • argments
  • i/o
  • error exception handling
  • model architecture

这样的话,自己implementation的时候会方便很多,同时本科小朋友帮忙跑实验也会简单很多(改参数就可以)。哦对了,还有一个要习惯用git。。

Torch Tensor Operation

这算是implementation时候的一个点吧。之前习惯了for loop,这次用多了pytorch tensor后发现实在是太爽了。不仅是速度提升(1000x),整个code 也elegant很多。说下从for loop 转成tensor operation的大概idea吧:

  • 如果index 不影响operation的话,可以直接用tensor[:]操作
  • 如果影响就需要 生成一个index tensor
    • 灵活利用torch gather(有一串index 和一个index对应的value, 想通过index取出所有对应value)
    • 利用torch where 来代替 if else

晒一下自己生成kbbox(对于每个点,return k个最近的且两点bbox间没有第三个点的所有neighbors)的elegant code吧(对比for loop):

For loop version:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
for size in range(SIZE_OF_NET):
num_of_sample = int(size)
data = train_data[size].cpu()
# data = train_data[size]
if(len(data) == 0):
continue
index = torch.zeros([data.size(0),data.size(1),num_of_sample]) #B,N,K
for N in range(data.size(1)):
#initialize all value as current node index N
index[:,N,:] = N
#for each batch B
max_sample = 0
print("PROCESS ",size)
for B in range(len(data)):
#for each node N
if(B % 1000 == 0):
print("PROCESS ",size,B)
for N in range(data.size(1)):
sample = 0
#We then check each point Q: whether the bounding box between Q and K has no other points, if yes, we add Q in index[B,N,:]
for Q in range(data.size(1)):
if(Q == N):
continue
#Coordinate of Q related to N
C_QN = data[B,Q,:] - data[B,N,:]
is_index = True
for J in range(data.size(1)):
if(J == Q or J == N):
continue
C_JN = data[B,J,:] - data[B,N,:]
if ((C_JN*C_QN) > (C_JN * C_JN)).min():
# print("Q cannot be index of N due to J",C_QN,C_JN)
is_index = False
break
if(is_index):
sample += 1
index[B,N,sample] = Q
if(sample > max_sample):
max_sample = sample
print("PROCESS ",size, "max_sample: ",max_sample)
torch.save(index[:,:,:max_sample+1],"../../data/tree/"+str(size))

Tensor operation version:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
#data : raw distance data (B,N,2)
data = tensor
if(len(data) == 0):
continue
# print(tensor.size())
B,N,_ = data.size()
# data = train_data[size]
# print(tensor[0])
#inner : (B,N,2) * (B,2,N) = (B,N,N )
inner = -2 * torch.matmul(data,data.transpose(2, 1))
xx = torch.sum(data ** 2, dim=2, keepdim=True)
#pairwise_distance: relative distance between N1 & N2 (B,N1,N2)
pairwise_distance = -xx - inner - xx.transpose(2, 1)
# print("pairwise_distance",pairwise_distance[0])

# BNN2 = data.view(B,N,1,2).repeat(1,1,N,1)
# BQQ2 = data.view(B,1,N,2).repeat(1,N,1,1)
# print("BNN2",BNN2[0][0])
# print("BQQ2",BQQ2[0][0])
#BNQ2: value in (b,n,q) is the relative coordinates between node n and node q at b_th batch.
# BNQ2 = BNN2 - BQQ2
BNQ2 = data.view(B,N,1,2) - data.view(B,1,N,2)
# print("BNQ2",BNQ2[0][0])
#CQN: value in (b,n,q,j) is the relative coordinates between node n and node q at b_th batch.
#CJN: value in (b,n,q,j) is the relative coordinates between node n and node j at b_th batch.
#UPDATE: The view step here is not neccesary since pytorch will automatically scale the tensor shape
CQN = BNQ2.view(B,N,N,1,2)
CJN = BNQ2.view(B,N,1,N,2)
# print("CQN",CQN[0][0])
# print("CJN",CJN[0][0])
#BNQJ: value in (b,n,q,j) indicates that when n is the centroid, whether j is in the bounding box of q and n (and such makes q not connected to j)
#True means the j influences q
BNQJ = (CQN*CJN > CJN*CJN).min(-1)[0]
# print("BNQJ",BNQJ[0][0])
#BNQJ: value in (b,n,q) indicates that when n is the centroid, whether q cannot connect to n
#True mans q cannot conncet n
BNQ = BNQJ.max(-1)[0]
# print("BNQ",BNQ[0])
#For those q who cannot connect to n (which is exactly True in BNQ), we assign a large distance value(10000)
_,index = ((pairwise_distance - (BNQ.long() * 10000))).topk(k=4,dim = 2)
# print("index",index[0])
# exit()
torch.save(index,"../../data/tree/kbbox_"+str(i)+'_'+str(j))

总结

这个work应该是自己这么多work里面最满意的一个了?虽然比较仓促,但是整个story是连贯的,对应方法也不是和一般dl-based work一样讲究一个玄学,基本都是有规律有原因能解释的。最后的结果也是比较满意(最后两三天的时候加上了FLUTE的结果实在是不太行,临时把FLUTE remove了,最后一天才算出结果。。也是没谁了)

这个要是结果ICCAD没中可就滑稽了。投paper这个东西就真的可以叫做玄学了。ß

写这篇文章的时候是5.20,也算是个特殊的日子。

本来一直想着等ICCAD搞完再写点东西。。但好多东西都是推到之后做,等ICCAD搞完想想申请PHD的事。。等ICCAD搞完学一下你不要担心的吉他。。。等ICCAD搞完想想感情的事。。加之这连续几天的失眠,感觉不写点东西,对自己赶DDL会有反作用了。

所以还是把五月份这段时间的(部分)想法先记一下吧。

厉害的本科生 高山流水

我是个不太喜欢吐槽的人……心里经常会告诉自己要做一个不怨天不尤人的好孩子……

但对不起今天实在是想吐槽一下了……

我记得我本科时候身边内地生同学都是大佬,没想过有些本科生水平可以这么糟糕

从linux怎么cp 到什么是make 到甩我一个c文件问我能不能帮debug,

真没想到给港中文本科生解决问题有教我爷爷用微信那感觉了,但问题是你们是港中文cse的本科生啊[捂脸] 我把command给你 你还少打了一串arguments,然后又问我为啥error;我告诉你scp 实在不会的话下个mobaxterm你嫌两个都太麻烦;……

算了 不说了,不过普遍来看内地生和部分local还是蛮厉害的,和这些同学沟通起来还是蛮舒服的,很多时候意会一下双方就明白意思了,有点高山流水的爽快感。

anyway 每天回复50+邮件的日子总算过去了……

(以上是之前发的朋友圈,觉得有损母校声誉于是删了,放这算一个备份吧(虽然感觉声誉本身就损的差不多了哈哈))

家乡的雨香

前段时间下了一次很突然的雨,突然到一瞬间就从白天到了黑夜。

之前对于雨没有什么特别的感觉,直到这次刚好写代码写的脑子晕所以打开门去阳台上休息会。打开门的一瞬间,那熟悉的雨的味道就回来了:呵,这不是家乡的雨香么!或者说,所有地方的雨香其实都是这样?但是不需要考虑这种理性逻辑因素,这样的雨香,我上次闻到,还是少年时代在家乡和小伙伴雨中嬉戏时的味道,这就够了。

然后心里合计着,好像真的很久没回家了。心里想家的想法一点点的膨胀,膨胀到看着远处的李兆基楼:怎么那么像我妈的那栋住院大楼。。🤦‍♂️。

没回家越久,便越睹物思人。偏偏今年的月亮又好几次特别大。每次看着月亮,就会陷入儿时和老辉他们中秋一起烤板栗的回忆,是啊,人生总得有这些浪漫的时刻与重要的人度过,这样才精彩,才能觉得来世上一遭不虚此行哪!

愿为江水 与君重逢

前段时间偶然在b站刷到了文在寅和卢武铉的故事。

先不论真相如何,至少所描写的故事实在是太对我口味了:两人都是抱着为民请命志向的君子,且都是高山流水的知音。卢武铉功成名就之时,文在寅默默隐退,卢武铉因为自身名誉自杀,文在寅复出,为了完成两人没能成功的理想:打败财阀,将幸福归于人民。卢武铉很喜欢江水这个概念,他认为人民就是江水,只有汇聚到一起,才能成为海洋,拥有惊人的力量。而文在寅的这句“原为江水,与君重逢”字如其意,希望有一天两人能在追求理想的道路上像江水一般,重逢。

就像个人英雄主义在欧美很吃得香一样,这样的家国情怀、士为知己者死的故事实在太对我们儒家文化圈的人口味了,归根到底,我只是一个生在儒家文化圈里的一个崇敬知其不可为而为之的书生而已。从诸葛亮,到于谦,再到隐形守护者里的那些为自己理想追求的人,所有这些有着坚定理想的人,是多么有魅力。

然后想想自己,其实还是很惭愧的。虽然自己有自己个人道路的理想,成为教授;也有对于社会的理想,见证一个真正的共产主义政府的诞生;但是好像没有做过什么为了理想而奋不顾身的选择:好像自己终究只是被生活逼着的芸芸众生,之所以会敬佩喝彩那些人,也只是因为自己做不到,所以将这希望寄托在他们身上?。

master of philosophy

可能是我离开了之前那个舒适圈,也可能是这次疫情给自己很多的“思考人生”的时间,自己好像确实有点像一个master of philosophy了。

大概就是,明显的能感觉到以前很多迷茫的东西、或者想不明白的东西,想通了,不害怕了,但想的人也没那么简单(或者说愣头青)了。不过这方面之前几篇月记也说过了,不谈也罢。

看得开 逃避

大概是18年开始,自己形成了一个比较苏轼的三观:大概就是一蓑烟雨任平生的豁达乐观、对任何东西好像都不是特别想争取,很看得开。不过这是说的好听的话、说得难听就是什么东西都会逃避。我对什么东西都不会抱很强的希望,可能是害怕求而不得的失望,不论是感情还是事业,都是随遇而安就好。

这种心态挺好的,但对应的行为其实并不显得好。就像我之前回忆我颓废的几年大学:得过且过的人生会像温水煮青蛙一样消磨人的意志和思想,当再想去追逐思考一些东西,比如幸福,的时候,人就像那青蛙一样,再也无能为力,只能抱憾终生。(说去题外话,自己很多时候只注意到表面上的收益或者得失,但很多东西是对我们有潜移默化影响而我们自己感觉不到的。譬如觉得一天工作16小时总工作量会最大化,但是花一点时间去外面呼吸新鲜空气 感觉自然的颜色,往往能给我们一种说不出来的畅快。)

所以总的来说就是。豁达的心态不代表什么都无所谓。很多东西,譬如感情、譬如事业,是要花心思去努力争取、维护的,不是摆在那里就能茁壮成长的。wuli小巍啊,要做一个像阿泽一样勇敢去争取的人哪。

家庭 远见 初中升高中

现在越发的感觉家庭对人成长的影响至关重要。不仅仅是性格上,还有人生抉择上。

倘若家长没有深刻的思想或长远的见识,孩子也不会有很高的远见。除非他在成长路上幸运的有了不一样的人生经历:书+思考,或是贵人指点+思考。否则,大概率孩子也会继承家长的短视。这怨不了家长,家长自己也不会意识到这点。他们中的大多数,都成为了一些冷门专业的学生,成为了大学迷茫随大流的孩子。不禁感慨,阶级跨越是有多难啊!

想起自己初中升高中的时候,其实自己也算是很有天赋的一个人,但是无奈没有系统性的教育,导致雅礼的精英班考试考的一塌糊涂:全都是没学过的奥赛内容,我怎么和别人学过的比?现在还记得最后语文作文知道自己肯定考不上,写了一段心里话:大概是表达自己的自卑,感觉考场里的别的同学都特别厉害,动笔就做,反观自己什么都不知道,完全和自己学的不一样,完全和自己随随便便全校第一的考试不一样。

如果时光能倒流,或者能写信:就像hey kong一样,我好想告诉那个自卑的孩子:你一点都不比别人差,你不会只是因为没人教你,没考上就没考上,未来你的高中照样很耀眼,你的人生也是走上了一条还算幸运的道路呀。

真的只能用幸运这个词。从高中见识到他山之高后的努力,到大学选了计算机专业,再到选择了mphi这条路,所有这些选择都不是什么有着父母、高人指导的远见之举,纯粹只是偶然、爱好、随波逐流,但是万幸,最后的结果不算差,虽然前方的路不像有些人那样到处都是灯光如昼,虽然自己前行的路需要黑暗中自己摸索,但是好像走的也算比较远了。

所以经常会想以后有了孩子会怎么样,会去发现他的各种爱好,倘若喜欢,就多去学点,万一在哪方面有天赋呢?还会督促他的学习,至少不会让他有那种自卑的瞬间。还会让他有个依靠,让他清清楚楚的明白爸妈会是他最后退无可退时候的退出。

哦不,是她。我想要女儿,哼。

小车结婚

小车结婚了,收到消息的时候先是一惊,然后就想起来余丝很早就和我提过这事。

然后就是长久长久长久长久 一直到现在还陷在里面的思绪。想到那时候还和她计划着一起去,想到不出意外明年结婚的就是我们了,然后又想到噢好像已经分手半年多了,然后梦到她嫁给别人,我不知道躲在多少个角落里哭了多少次。

好像自己还是那么想她。没有她我就感觉要死掉了的那种想。之前有过感慨要是自己不是和她谈对象该多好:两个单亲家庭的孩子互相喜欢真是人间最大的悲喜剧。但没有这么多要是,就算有如果、有平行时空,我唯一知道的是,我在的这个时空,这个我学了计算机以后可能要去读PHD的时空,不管别的平行时空怎么样,不管我们是不是合不合适,她就是我唯一的意难平、就是唯一的那个分手后会让我听着李宗盛哭一垃圾桶纸的人、唯一那个陪了我度过整个青春的人、唯一这么久后会因为同学的结婚又整晚整晚睡不着的人。

其实也不是没有去试着喜欢别的女孩子,但没有什么人什么事能让随遇而安的我有一点点的波澜。好像有比她漂亮点、高一点、学历好点,但这种纯粹的对比只是成人世界中的,在真正的感情里是没有这些成年人基于表面价值的价值判断的:当你拿着秤砣去衡量一份感情,这感情就掺杂了你以为的表面价值,最终只会失去原本的、弥足珍贵、许多人求之不得的感情。

分开的原因

好像说了这么多一直是在说她有多好。或者说对我多重要。

换个话题,说说为什么分开吧。

这段波折的感情史,第一次大的波折应该是那次她离家出走。在那之前,初恋的我还是对恋爱有一些幼稚的、理想国般的幻想的(本来她也是,但不知道什么时候开始变得)。

大概就是说好两个人不能给异性发表情包(哈哈哈我们当年是怎么提出来这种奇葩要求的),结果我那天看到她发了,于是质问她,要求她以后不能发,但被她冷漠的拒绝了。但论这件事放在我现在看,我会更加站她一点,虽然是说好的,但是这个说好的本身也太。。不过当时她那张冷漠绝情的脸真可以说是让我毕生难忘,也直接给了那个还报美好幻想的少男一次感情上的核打击:原来一个人可以变得这么快,前一秒还是少男少女的如胶似漆,下一秒直接绝情的好像不曾爱过你。其实思想,尤其是初恋男女对于感情的思想,是需要时间去成熟的,但那次就好像飞机没有软着陆而直接坠落在机场一样,好像自己对于这段爱情的所有期望都全破灭了,然后就变成随遇而安的状态了。后面和她说过这件事对我的伤害、她也嘟囔了一句对不起(我能感觉到她是真的歉意),但我随遇而安的态度从那之后好像就一直没变。

类似的是,我们的感情里面她也有一次“坠机”般的硬着陆。有次分手后没几天,我去北京开会认识了一个姑娘,然后两个人也聊的很来。我好像就是这样贱(渣),因为习惯了和她在一起时有个依靠,所以她一消失会急于寻找一个替代:听起来有点辩解的意思,但是好像就是如此,我从小就没有一个和睦的家庭,一个可以当作港湾的家庭。对我来说,我这辈子,有过的唯一依靠,就是她。后来她来找我和好,但是我没有和那个姑娘说,只是刚好自己回香港所以也直接对那个姑娘冷淡很多。再然后被她发现了,我能感觉到她是真的真的好难受,就像我那次打碎了对爱情的所有期望一样,她也打碎了她的美好的期望。。。虽然我道歉哄好了她,但是那段时间我做的真的不好,可能是因为自己已经成为随遇而安的性格。我现在很后悔的是,她“坠机”后没能重新让她上一架新飞机,没能告诉她 这个世界上她是除自己之外对我最重要的人,也没能生活上细节上注意一下她微小的情绪:如果当时我就看了1988该多好。

总之经过这两件事,我变得随遇而安,感觉什么都随自然就好,包括感情。她变得对我们的爱情失去信心,再加之我随遇而安的态度,开始越来越失望,越来越不重视感情。

然后就是导火索了,大概就是她和同事出去吃饭,说好晚上10.00-11.00回来,结果12.00还没走,而且一晚上不主动发微信消息。然后我很生气,结果她一副“我错了 然后呢“,一直跟我”据理力争“,真是把我气的不行(我现在想来都好委屈好气,明明是她做错了,而且错的还很厉害,为什么可以这么嚣张 还 想先给我扣一个我也干了的帽子然后来批判我。)不过这个导火索算是偶然中的必然吧?一个随自然的人,加上一个不重视的人,总会出现类似这样的事。

两个人都是彼此青春的见证者,更要命的是因为单亲,还都是彼此最重要最融入人生的那个人,好像就这么错过会太遗憾了。不知道何时才能解除封关,那时候应该会去再加油一下吧。至少要把这些东西告诉她吧。

要做一个像阿泽那样的少年哪。

建议配合 https://www.bilibili.com/video/av56239558?from=search&seid=14406218127146760248 食用。

关于read paper:我个人觉得有两块要读(思考):一块是算法上,有什么interesting或者amazing的算法值得学习。另一块就是经验、思想上,作者是如何提出这个方法的,这个方法背后蕴藏了什么思想/经验。

Background

  • RNN不利于parallelization
  • Attention可以无视sequence距离挖掘信息。(我爱这个笑着眼睛像月牙弯弯每天都像阳光一样点亮我的你-> key information:我爱你)
  • 如今的attention(16年)仍然是和RNN一起出现(used in conjunction with recurrent network)
  • 现在的work:要么不能并行。要么可以并行(例如CNN)却不能挖掘远处关联。(我爱月牙弯弯)
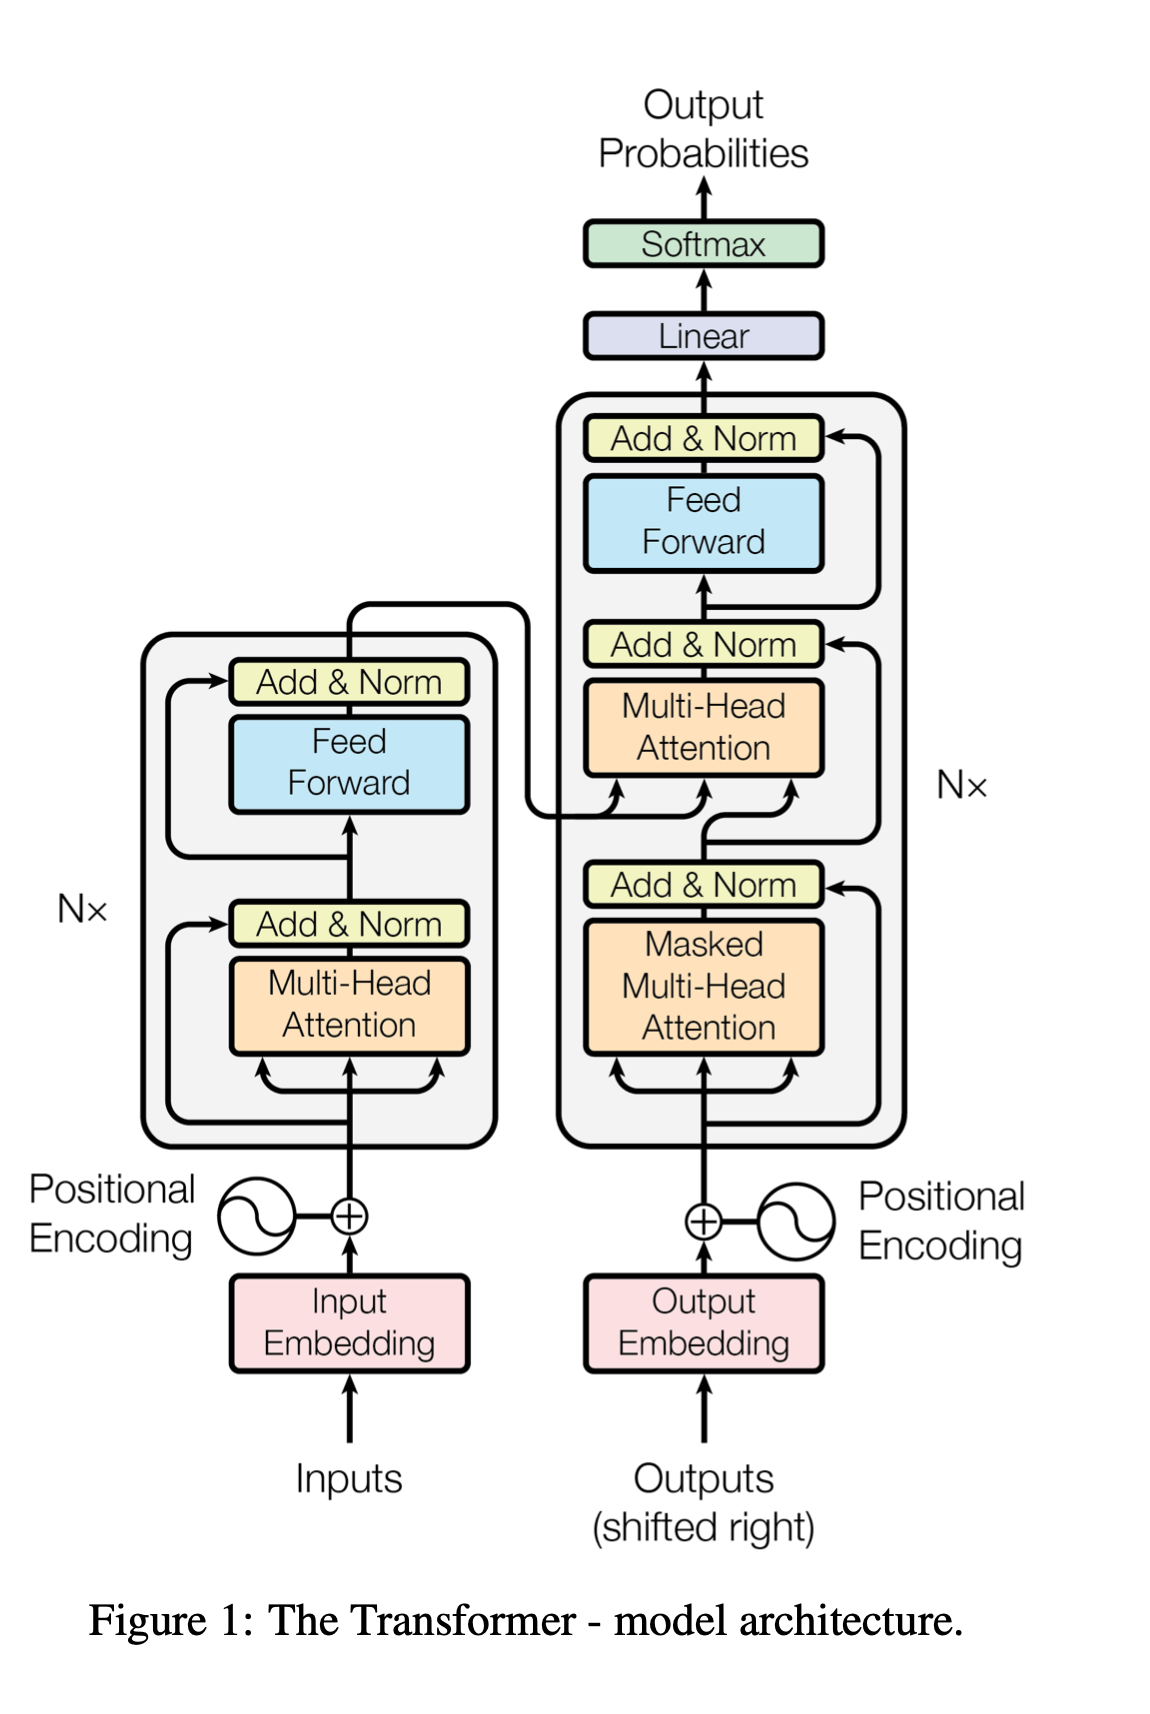
  • Tranformer:第一个完全利用self-attention计算input和output的representation。(不用RNN,CNN)

Include 反义词: preclude 排除,杜绝:This inherently sequential nature precludes parallelization within training examples

albeit:尽管

Model Architecture

Overview:

image-20200426111253973

1
2
3
4
At each step: (sequence to sequence should be generated step by step)
middle sequence z = Encoder(Input sequence x(我爱你))
output sequence y_t = Decoder(z,y_{t-1})
注意:图中右下角的output为之前的输出。

Encoder

  • LayerNorm(x + multi-head(x))
  • LayerNorm(x + feedforward(x))
  • keys,values,querys: input x

Decoder

  • Addtional sublayer compared with Encoder: Masked attention layer(ensures that the predictions for position i can depend only on the known outputs at positions less than i.)

  • Keys, values: middle sequence from encoder

  • querys: Masked multi-head attention

Self-attention

A mapping from a query and a set of key-value pairs to an output

output: a weighted sum of the values, where the weight assigned to each value is computed by a compatibility function(适合性方程?总之就是计算相似度) of the query with the corresponding key.

image-20200426115525168

$Q: [seq,d_k], K:[seq,d_k],V:[seq,d_v]$

$seq$: sequence length

注意 原x dimension 为$d_{model}$, 经过linear projection转化为 $d_k,d_v$ dimension

Multi-head

$x:[d_{model}] => [h *d_v]=>[d_{model}] $

h:head数目。(multihead最后concat起来,所以是$h*d_v$)

再经过一次linear transform到$d_{model}$

Positional Encoding

常见的position方法就是one-hot encoding,但显然不能input dimension匹配,而且若用one-hot encoding 直接sum 未免显得太蠢。

Transformer提出了利用正余弦的方法:

image-20200426140105603

PE即为目标embedding。pos为word所处位置,2i即为 $d_{model}$中的维度之一。

  • PE(:,x)即为$x_{th}$ dimensition下所有position的维度。 可以看到是一个周期函数
  • PE(x,:)即为$x_{th}$ position下的embedding,是一个从波长为2pi 到 10000 * 2pi的函数。

但这里反直觉的是 PE是和input直接相加。而不是concat。。。 奇怪呢。

Dropout -> Residual -> Layer Normalization (Some papers claim that layer normalization should be in the sub-layer instead of behind residual summation)

Why self-attention

  • # of operations
  • Parallel
  • path length between long-range dependencies in the network

Results

  • Dropout 效果明显

1988

看很多人说1988后劲很大,我觉得后劲这个词实在是用的太妙了。

不过这后劲倒不是什么贬义词,相反,我还期盼着这辈子都能有这种后劲。至少,心里会时刻警醒着自己。

前几天读了高中毕业时写的文章,一方面庆幸自己写了一些记录自己思想和记忆的有意思的东西,另一方面又感慨:自己曾经也是个意气风发敢爱敢恨的少年哪。大学几年的颓废生活不仅把身子养颓废了,更重要的是把人的思想变颓废了,不再去思考人生,不再去感受周边的环境和人物关系,整个人也只会变得越来越行尸走肉,当想要追寻一些关于幸福的答案时,便只能无力。我想,这是我们为什么要做一个温暖的人、一个经常思考的人。

高武

说到高中,自从知道了那件事后,很不想再和过去的时光有什么瓜葛:有点我以我心对明月,奈何明月照沟渠的意思。但是对于高武,确实是让我感动到耿耿于怀的:那个在草稿本上写满武定中原,看起来深不可测的高武,高考前两个月一直和我小姨发短信说我压力很大让小姨安慰安慰我。高中刚毕业时,对于这些,粗线条的我只是感动,然后一带而过。但现在越发觉得,要做到这一步,实在是太无私伟大了。人生在世,大多数人只是为了自己:和你相处是为了自己的前途或是为了自己能开心,倘若你对我的前途无用、或是你惹的我不开心了,我屁股一拍就可以溜了,临走时还可以忿忿道对方如何如何不好。而像高武,便是我钦佩和想成为的,温暖而不张扬,照顾他人情绪而不仅仅是为了自己。可惜的是高中后便和他断了联系,纵使一直qq找他也了无音信。

感情

还是忍不住去撇了眼余丝的微博。有一条让我很委屈:大意就是从前那段日子很黑暗,不过好在现在过去了。

我不知道是不是很多女生喜欢借着丑化前任来彰显自己的无错和可怜,但是我们的分手明明是她做错了。明明是她说好十点回宿舍结果玩到12点也没微信消息,然后还一副“我错了然后呢“的态度。结果好像又变成了对我的批判会:不过现在我不需要参加这个会了,我只是像一个特工一样暗自去她的微博看她的“批判”就行,而不是带着高脚帽站在台子上被训斥。

至少在我看来,我唯一的这段恋爱,虽然由于都是初恋,两个人性格都不成熟,但我还是可以称之为幸福的,再怎么样也算不上黑暗:除非我是真的没了解她。在我看来,这么多年两个人是真心喜欢的,不然也不可能都不成熟的两个人硬是如两个刺猬拥抱在一起一样坚持了这么久。有很长一段时间,两个人最重要的人都是彼此,也可能是这个世界唯一的牵挂:毕竟双方还都出自单身家庭。

但仔细想想,总的来说,我其实有很多地方都没做好。譬如在她脆弱犹豫缺乏安全感的时候,没有明白的表示自己心意,告诉她她对我来说多么重要;譬如很多生活上的细节忽视了她的感受。啊。。也许这是单亲家庭的通病吧:没有见识过幸福的家庭和爱情,所以不知道那样的家庭爱情的日常是怎样的。所以,为什么没早点看1988,没早点想这些事呢。

成长

大概是分手后?感觉自己在思想上疯狂的成长:可能是跳出了之前本铺好了的人生大道的舒适圈,所以危机之时必须考虑一些问题:感情、人生、事业。

思考这些问题,真实的让我成长了。不知什么时候起,我逐渐不需要依靠爸妈,而是恰恰放过来,他们需要依靠我了,很多事情,事业上的,人生上的,他们会问我的想法,寻求我的意见。

其实我也不能在把自己当作孩子了,我可是二十三了,搁古人这已经是立不世之功的年纪了。不过很庆幸在这个即将成为顶梁柱的年纪想明白了很多思想上的事,自己也形成了稳定成熟的三观,可以让自己不在这个信息碎片娱乐至死的社会活的迷茫。

好了,得睡了。最近又失眠了,褪黑素好像也不管用了。没办法,只能睡不着的时候办公:只要coding的够晚,失眠就追不上我。

我是个很少看剧的人。在我看来,冗长的剧情、尤其是毫无营养又冗长的剧情、尤其是毫无营养又冗长的宫廷剧实在是浪费生命。不过我为数不多的几次看剧都是真香结尾:大学的射雕英雄传,信号真香了,这次的1988也真香了。用真香这个字眼其实也不太准确:我还是对豆瓣高评分的事物抱有期待的,毕竟自己也只是个喜好和大众口味很匹配的芸芸众生之一。

照例。写一些自己印象深刻的点。

乌邦托

胡同里的所有人都太温暖了,温暖到我觉得这只可能是个乌邦托。德善很想被疼爱,但是只有两个荷包蛋时还是说自己不用,虽然自己其实也很委屈。爸爸知道了德善的委屈后,也可以如朋友般的和德善坐着聊天:”德善啊,对不起,爸爸也是第一次做爸爸。。“。善宇怕妈妈担心,把妈妈做的盒饭在进门前全吃完了。阿泽在知道爸爸的想法后,坦率的支持爸爸:“我只希望爸爸能过得幸福,毕竟爸爸也有自己的人生。”。正焕知道妈妈的情绪后,故意搞砸家里的事情。。。

虽然只是乌邦托,但是发现,做一个温暖的人、细心的人是真的很好哪。这些品质可以不被外界事物影响,留在自己身上一辈子,并且可以温暖到周边的人,这不是很幸福的事吗?其实说起来,从小寄人篱下的我从前倒挺会察言观色的,说好听点就是细心体贴,不过初三过后性格实在是变得太多太大条了,开朗如娃娃鱼可以,但是娃娃鱼好歹还是个人生导师、情商拉满呢,哪像我技术也不行,情商也不够,细心也丢了。

喜欢

不知道是逛虎扑知乎微博逛多了,还是自己变得现实了。

看完剧,想想自己。好像丧失了十几岁的那种喜欢,那种只想无条件对喜欢人好的喜欢,现在的自己变得很担心自己陷进爱情里,担心自己对她太好就是“舔狗”。其实想想,无条件对喜欢的人好就会是丧失自我的舔狗吗?恰恰相反,因为这些想法而丢了纯真的喜欢才是真的丧失自我,不是女方的舔狗,是“世俗”的舔狗。

什么是少年感?少年感是阿泽跟着去卫生间,还假装抽烟照顾德善的情绪。是正焕看着电影义无反顾的开车回去。是善宇的喜欢就是喜欢。很多时候,我们做出的选择是基于利益判断的,能赚钱是正收益,能提高ta对我的好感是正收益,如果付出的抵不上回报带来的数学期望,我们就不做了。但若尚为少年,怎么会考虑这么多东西?意气风发的少年是纯粹简单的。我喜欢你就是喜欢你,就是和你在一起就会很高兴,你不在就感觉要死了。所以会对你好,会吃醋,会关心你的动态,会照顾你的情绪。这些都是因为我喜欢你,也只是因为我喜欢你,如若有其他的原因,譬如希望在一起,那也变味了。

另外,还有一个也许看了这部剧的所有人都会同意的想法:爱就要大胆表现出来,命运不仅仅是偶然,是许多次要做出选择的瞬间组成的,让人讨厌的不是红绿灯,也不是时机,而是我的无数次犹豫不决。其实不仅仅是爱情,还有亲情,友情,许多东西都是如此,我爱你,所以我会表现出来,表现在方方面面,就像春天到来,你能闻到花香、听到鸟鸣,感受到舒服的阳光一样。

阿泽

比起简直就是初中前我的翻版的善宇,阿泽就是我的白月光啊!那种特别喜欢的人,那种特别想成为的人。温润如玉波澜不惊的性格真是太对我胃口了(我也不知道我现在怎么就是娃娃鱼的性格)。再想想自己高三努力的样子,发现我这个人真是个一辈子下来可以变化很大的角色。

像之前提到的,他很温暖,会照顾他人的情绪,娃娃鱼生气只有自己不知道善宇谈恋爱的事时立刻跳出来说自己也不知道(虽然撒谎很拙劣)。他对于自己的喜欢很坦率简单,我喜欢德善,喜欢女人的那种喜欢。他也很真实,放弃了自己喜欢的女孩后,会流泪难过,知道对方的心意后,又很直接的吻了上去,而不是像成年人一般有这样那样现实上的顾虑:那样多累啊?他还有我最想有的一点品质:知世故而不世故。采访了很长后,没有生气,而是说很晚了,让社长和他们一起吃晚饭。

就像弹幕说正峰的一样,阿泽也是“吾辈楷模”啊。希望自己以后,也可以成为一个如他般温柔细腻、知世故而不世故,一眼看过去就是干净简单的人。

自己的回忆

好像每个人都能从这部剧里面找到代入感一样,很多男生是正焕,是啊,青春期的男生,有几个会如阿泽善宇般直率的表白自己的心意呢。而我,肯定就是善宇了。所以从一开始就对这个男生有着先天的好感,懂事的令人心疼、会小心翼翼的照顾妈妈的想法,成绩也挺好,看着他穿白大褂的样子真有点恍惚:就好像我是医生一般。

同样也有一个院子长大的玩伴,不过自己不会表达想法的缺陷也让整个回忆没有剧里那么多友情有关的故事。有次,我和老辉看到肖华正在哭着拦着正扭打在一起的父母,我们两个只是苦笑:没有后续的行动了。我们两个也都有过类似的经历,所以苦笑,我们两个都不是那么温暖照亮他人的人,所以没有后续了。我想,如果是剧里面的任何一个少年,都会去安慰他吧。

剧看完了,其实更多的还是恍惚、难过、不舍。不仅仅是对剧,还有对剧里所代表的那段时光和感情。我已经不是中学生,甚至大学生都算不上了,学生时代的爱情和我估计也是没什么缘分了,和家人邻里也不可能有长时间的相处了,朋友好像也只有博一一个可以称为挚友。

不过也不算太糟:学生的爱情不可能了,但我还可以如少年般的去喜欢一个人。家人邻里不能长时间相处,但我也还可以做一个温暖的人,朋友有博一还不香吗,博一这样简单的人世上能碰到便算作有幸了呢!

差不多也到结尾了,写完这一通,好像也活得明白通透了一点,希望自己如自己所愿,做一个简单的少年。

三月过去了一半,整个二月,包括这已经过去的三月,都是颓颓的在宿舍度过的。这段时间每天做些什么呢?

十点多迷迷糊糊起床,玩手机到十二点,然后煮饭吃饭到了下午两点,稍微刷下虎扑知乎加写下代码,哦豁又要吃晚饭了。晚饭一过,就是各种娱乐活动了,913吃鸡,之前的剧本杀,现在的冬日计划,还有打了好几遍的三国志。。。

发现脑子这个东西还是得经常用经常转。之前划水的时候以到下午头晕的不行,但是有天强逼着自己学习写code,居然就不晕了。呵呵,我这叫做富贵病吗?

感觉不能这么浪费自己生命了,至少白天不能再手机综合征下去了。(其实颓的很大一个原因,是真的眼前这个OpenMPL的coding太过烦人,不过索性最终还是在今晚解决了,希望以后可以更有朝气的做接下来的许多许多事情。)

工作方面就是这样,说起来随着疫情的严重,intern的日期可能也需要变化,可能要推迟到下学期?不知道,但总之得尽快和老板确定。什么时候确定?等我openmpl搞定后才有底气说吧:毕竟确实划了太久水。

发现自己现在是个看得很开的人,不管是感情还是事业。有点命中有时终须有,命里无时莫强求的想法在三观里了,很多东西不太愿意投入太多的热情和希望,可能是害怕失败后的失望?不论好坏,但至少大部分事物不会让我捶胸顿足,喟然叹息,感觉也是成熟的一个小小标志吧。

最近唯一让我有点情绪的是妹妹的事。和妹妹视频,五岁的小孩子一句话不说,然后眼泪就流了出来。这么小就有了难以承受的心事,这么小就得寄人篱下 没有父母的照顾,这么小就眼泪憋不住的无声的流。看着真的揪心难受,既然选择了做父母,为什么就只管生不管养呢。不希望她重蹈我的覆辙,她这么可爱 ,这么漂亮,她值得拥有自己人生的幸福。

不过家家有本难念的经。我为我妹妹的人生叹息,我爸的人生也活得挺糟糕:生意上的不顺、女儿的身疾,都让这个中年人压着担子。哎,他的担子何尝不是我的担子呢。

今天忽然看到詹青云是12届的CU本科生,忽然惊了一下,想到自己14年入学的时候唯一报名的国辩队,没准当时她也在台上。然后觉得自己的青春这一点上挺可惜的,唯一报名的原因是确实当时只对这个有浓厚的兴趣,但是碍于懒惰,碍于一般家庭出生的短视,碍于自己的懦弱,最终还是没有去参加复试。也许参加了会有很多全新的体验、很多新的朋友、自己的思想也能系统化、逻辑化,对自己人生规划也会健全很多。

不过往者不可谏,来者犹可追。未来可能还会有这种辩论的机会(哈哈,不过就算有机会,也没有时间去准备、去充实自己了吧?),再不济,其他喜欢的东西一定要去追求一下。Follow your heart。

药效好像快到了,得睡了,晚安。Neway。前几天那个超大月亮确实很大,希望未来的某天你再看到月亮的时候,你找到了那个爱你的人。

Here, I list the pseudocode of this algorithm, I didn’t implement it since it wasn’t critical for my journal…

But If you are required to implement a DL with dynamic working stitches. Hope this piece of code helps you. :)

The basic requirement of “dynamic” is:

  • Given a working stitch k in each polygon, the alg construct corresponding coloring rows in the dancing links.

    Note that we need exactly k working stitches instead of # <= k (Since the optimality of DL is constraint by the row order, for example, if one polygon $p$ contains three stitches, then the rows indicating $p$ at beginning should be the coloring solution without working stitch, following is the # of exactly one stitch… and so on

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def insert_exactly_k_stitches(k):
for p in parent_node:
if (|stitches_p| >= k):
recursive_insert(k,stitches_p,selected_stitches)

def recursive_insert(k,stitches_p,selected_stitches):
if(k>0):
for(stitch in stitches_p):
if(stitch not in selected_stitches): #select the stitch edge which has not been selected (to ensure exactly k different stitches are selected(working))
stitch = selected_stitches[k-1]
recursive_insert(k-1,stitches_p,selected_stitches)
else: #k = 0
#For the layout, one working stitch increase exactly one subcomponnet, therefore, there are pow(3,k+1) rows if we didn't consider the same coloring constarint(such as 1-1-1 for 3 sub-components).
# For example, given two working stitches, which divide the polygon into three subcomponents, the total possible coloring solution for TPLD should be:
#0-1-0,0-1-2,0-2-0,0-2-1,1-0-1,1-0-2,1-2-0,1-2-0,2-0-1,2-0-2,2-1-0,2-1-2
divide the polygon into |selected_stitches| features
recursive_color(|selected_stitches|, coloring_results)

def recursive_color(h,coloring_results):
if(h>0):
for(color in possible_colors):
coloring_results[h-1] = color
recursive_color(h-1,coloring_results)
else:
if the coloring is illegal constraint by selected stitches:
continue
#NOTE: here we may not need to remove illegal coloring! Guess why? because it doesn't influence the optimality, only possible efficiency is influenced. Since we certainly call insert_exactly_k_stitches(0), insert_exactly_k_stitches(1), insert_exactly_k_stitches(2)... and so on. If we delete this part, it means that the alg not onlt inserts exactly k stitches, but also working stitches whose number less than k
else:
insert row according to the coloring results

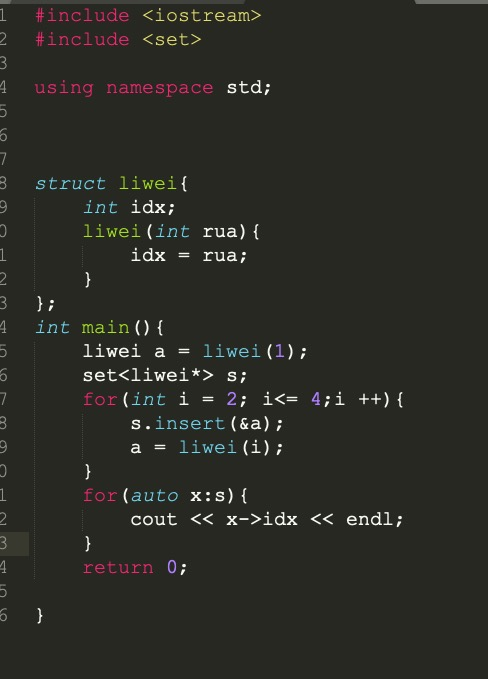
for 循环中新建structure

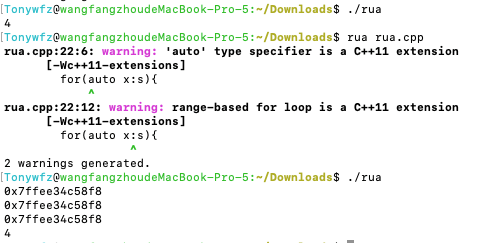
如果直接用 Structure a = Structure(args), 这个loop里面的a都是一个address

image-20200314193421233

image-20200314193430528

解决方法:new

1
liwei* a = new liwei(i);

klayout中的那些事

因为openMPL 需要用Klayout处理一些gds的input 所以学了些klayout中的技巧,记录如下。

先吐槽下当代科技的gds有多大:

510bee9938b4657441398f1bcf49d71

path to polygon

由Dr.CU 生成的layout 所有feature是以path形式存储的,感谢Haoyu提示klayout有直接转的方法,遂Google,方法如下

8d83caece09045a3173787405db5c82

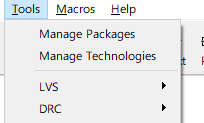
  • Tools->DRC

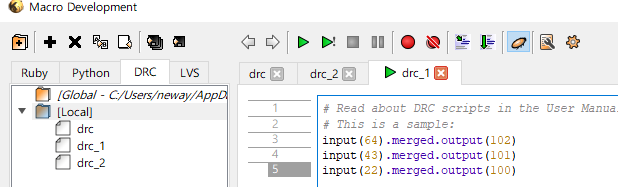
6fa9ece7a726602e1bf8ae952d35fc5

  • input(x).merged.output(y) 意思就是把x layer merge起来(猜测merge的这个operation就会把path及其相连的path merge成一个poly) 然后输出到 y layer。万幸Dr.CU生成的layer都是固定63,43,22可以用来decomposition(不然我一个一个点一个个放大看真的要吐)

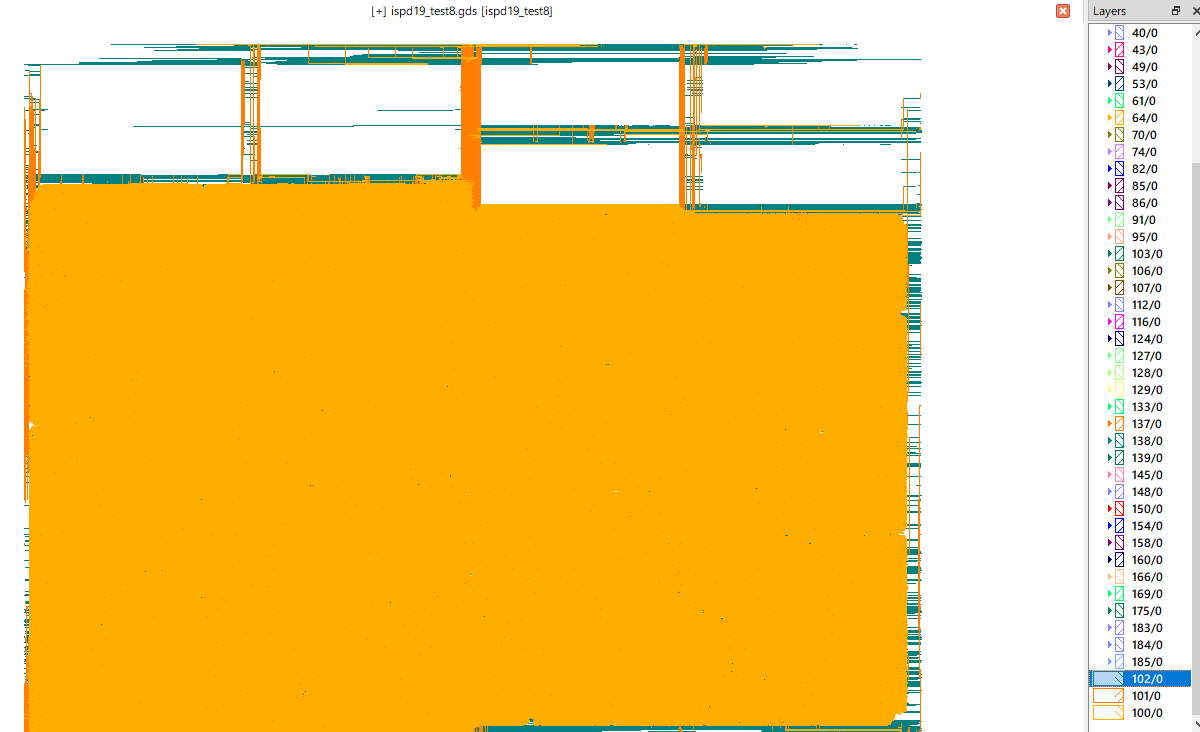
c1c3ecdbd3929eb17f24c1c0068bcae

可以看到右下角就是生成的100,101,102 layer了,这时候我们visualize三个layer (后面保存的时候可以选择只保存被visualize的layer)

Flatten cell

layout中的feature其实是以cell为单位分布的,而cell又取自某特定library中(比如加法器就是一种cell,一个layout里面需要多个加法器)Ps:只是我现在的理解。

因此有些gds文件存储cell是以一个指向library的指针存储的(这样不用存储所有poly的各个点坐标了,只要存library中所有cell的具体信息,以及layout中cell的相对位置就可以了)。

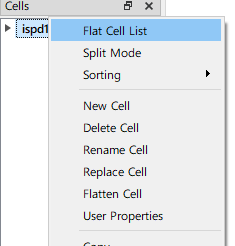
现在的OpenMPL暂时不支持这种gds文件,因此需要把所有cell flatten,即不存指针,而是直接存指向的cell本身。

3aa8e614d6c455e9c42c37e04768a3a

左边 右键 选中flatten cell

选择性保存

gds里面有许多layer用不到,我们选择性保存我们需要的100,101,102

15fb86600eec3ad3db5b419fa855a30